

ByteDance: Doubao-Seed-ASR-2.0 是字节跳动/火山引擎推出的大模型语音识别服务,可将录制的音频文件转写为文本。它基于在海量真实语音数据上训练的 20 亿参数音频编码器构建,在噪声、多人说话和特定领域的录音中均能实现高精度的转写。主要功能:- 高精度:错误率较传统模型降低约 30%,在垂直领域(音乐、科技、教育、医疗)降低 50% 以上。口音错误率降低约 60%,噪声/背景语音错误率降低 30-50%。- 多语言和方言:支持中文及方言(上海话、闽南语等);2.0 版本 (Doubao-Seed-ASR-2.0) 新增 13 种外语(日语、韩语、德语、法语等),并提供针对专有名词、姓名和同音词的上下文感知推理能力。- 丰富的文本格式:内置自动标点、逆文本归一化(数字)、语义平滑和智能句子分割,且均可单独开启或关闭。- 长音频处理:支持长达 5 小时的文件处理。
返回模型列表 -$0.0000327/秒-读取:-/ 百万 token写入:-/ 百万 token1.02K--
供应商
在多个供应商之间路由请求。复制供应商标识以设置偏好供应商。
供应商缓存命中率上下文
Volcengine
volcengine
可用率
24 小时AI Gateway 直连请求及各供应商的成功率。
Oct 26, 19:49
Volcengine100.00%
吞吐量
24 小时AI Gateway 实时流量的 P50 吞吐量,单位为每秒 token 数(TPS)。
No data
延迟
24 小时AI Gateway 实时流量的 P50 首 token 延迟(TTFT),单位为毫秒。
No data
活动
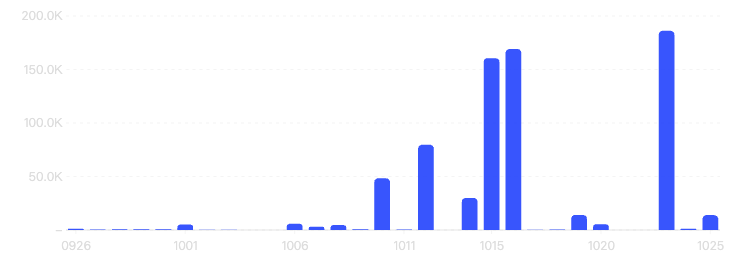
该模型随时间变化的 token 用量和请求流量。
Token 消耗
Oct 25
Volcengine13.9K
按实际处理请求的供应商拆分 token 用量。区块越大,表示该供应商处理的模型流量越多。
 Artificial Analysis
该模型暂无基准测试数据。
Apps
Public apps that send the most traffic to this model. Good signal for what real production workloads look like — and a hint at which use cases this model is best suited for. View All
Token 排行

相关模型
更多模型来自 ByteDance