
MiniMax-M2.1 是一款轻量级、最先进的大型语言模型,专为编程、智能体工作流和现代应用开发而优化。仅需 100 亿个激活参数,它在保持卓越的延迟、可扩展性和成本效益的同时,实现了实际应用能力的重大飞跃。与前代产品相比,M2.1 能提供更简洁、更准确的输出,并提供更快的感知响应时间。它在主流系统和应用语言中展现出领先的多语言编程性能,在 Multi-SWE-Bench 上达到 49.4%,在 SWE-Bench Multilingual 上达到 72.5%,并可作为 IDE、编程工具和通用助手的多功能智能体“大脑”。为避免降低模型性能,MiniMax 强烈建议在多轮对话中保留推理过程。
返回模型列表 48.4%$0.3/ 百万 token$1.2/ 百万 token读取:0.03/ 百万 token写入:0.375/ 百万 token204.8K1.62s39.1tps
供应商
在多个供应商之间路由请求。复制供应商标识以设置偏好供应商。
供应商缓存命中率上下文
MiniMax
minimax
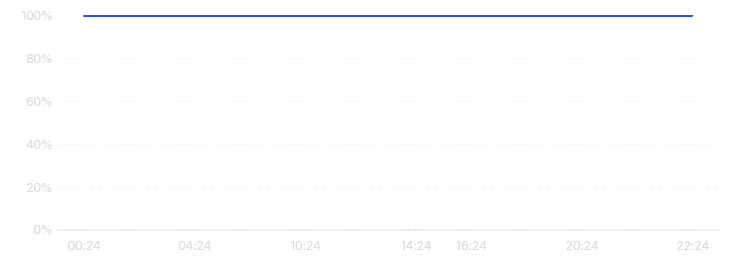
可用率
24 小时AI Gateway 直连请求及各供应商的成功率。
Oct 26, 16:24
MiniMax100.00%
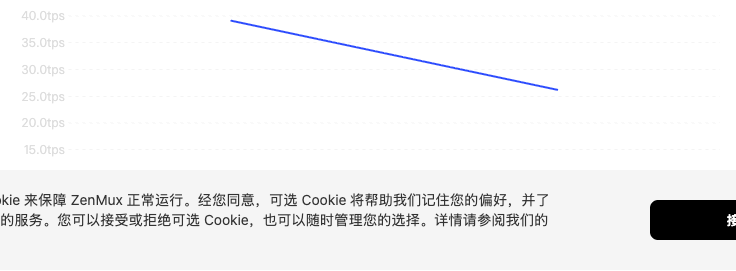
吞吐量
24 小时AI Gateway 实时流量的 P50 吞吐量,单位为每秒 token 数(TPS)。
Oct 26, 03:00
MiniMax39.1 tps
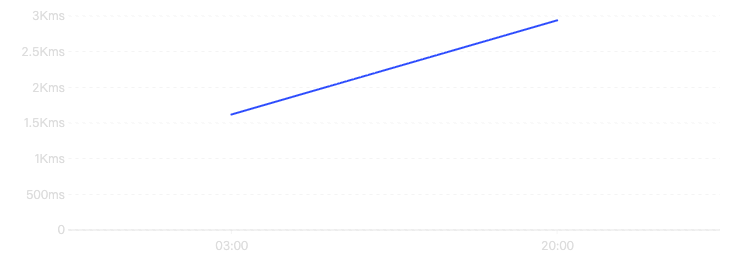
延迟
24 小时AI Gateway 实时流量的 P50 首 token 延迟(TTFT),单位为毫秒。
Oct 26, 03:00
MiniMax1.62s
活动
该模型随时间变化的 token 用量和请求流量。
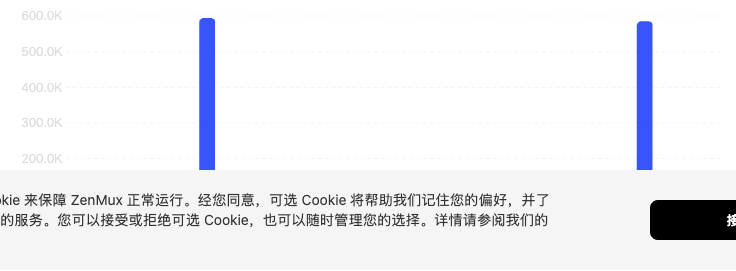
Token 消耗
Oct 25
MiniMax79.3K
按实际处理请求的供应商拆分 token 用量。区块越大,表示该供应商处理的模型流量越多。
 Artificial Analysis
Apps
Public apps that send the most traffic to this model. Good signal for what real production workloads look like — and a hint at which use cases this model is best suited for. View All
Token 排行

相关模型
更多模型来自 MiniMax