OpenAI: GPT Transcribe 是一款来自 OpenAI 的高精度语音转文字模型。它适用于录音、流式文件转录以及已提交的实时会话,并支持自由形式的上下文、关键词提示以及用于专业术语和多语言语音的多语言提示。
我们使用必要 Cookie 来保障开桥正常运行。经你同意,可选 Cookie 将帮我们记住你的偏好,并了解你如何使用我们的服务。你可以接受或拒绝可选 Cookie,也可以随时管理你的选择。详情请参阅我们的 隐私政策。


OpenAI供应商
OpenAI 提供的模型服务条款
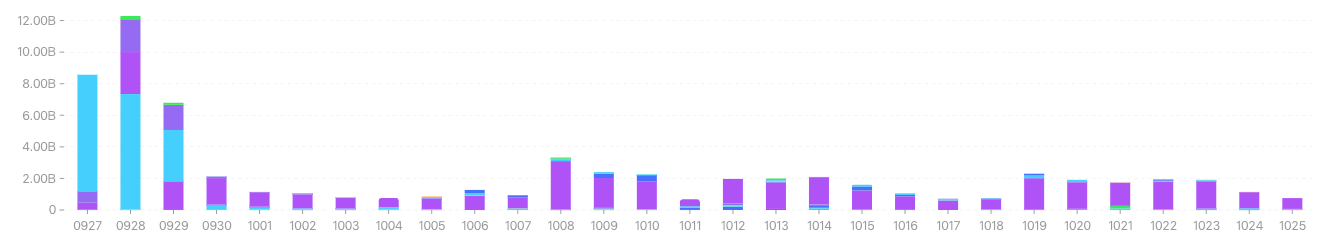
模型 · 33
OpenAI: GPT-Image-2
openai/gpt-image-2
3.72Btoken
0%缓存命中率
输入类型
输出类型
输入$8/百万 token
输出$30/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-Image-1.5
openai/gpt-image-1.5
26.91Mtoken
0%缓存命中率
OpenAI的GPT-Image-1.5是其AI图像生成的最新进化版本,提供卓越的指令遵循、逼真度、文本渲染和编辑控制能力,使其成为详细创意和生产工作的理想选择,且比DALL-E 3等前代产品速度更快、成本更低。它擅长处理复杂请求,保持角色/风格一致性,在视觉中呈现清晰的文本,并通过内置推理理解细微的提示,已集成至ChatGPT并可通过API使用。
输入类型
输出类型
输入$8/百万 token
输出$32/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-Image-2.5-Sunburst
openai/gpt-image-2.5-sunburst
753.64Mtoken
0%缓存命中率
OpenAI: GPT-Image-2.5-Sunburst 是 OpenAI 推出的图像生成与编辑模型,定位为 GPT-Image-2.5 系列中注重精度的层级。它通过专门的 Images API,适用于对编辑准确性要求高于生成速度的详细创意工作。
输入类型
输出类型
输入$8/百万 token
输出$30/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-Image-2.5-Flare
openai/gpt-image-2.5-flare
167.83Mtoken
0%缓存命中率
OpenAI: GPT-Image-2.5-Flare 是来自 OpenAI 的图像生成与编辑模型,定位为 GPT-Image-2.5 系列中注重速度的层级。它适用于通过专用 Images API 进行的大批量日常生成、创作者内容制作及快速原型设计。
输入类型
输出类型
输入$8/百万 token
输出$30/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: Text Embedding 3 Small
openai/text-embedding-3-small
1.74Btoken
0%缓存命中率
OpenAI: Text Embedding 3 Small 是 OpenAI 对 ada 嵌入模型进行的改进且性能更强的版本。嵌入是文本的数字表示,可用于衡量两段文本之间的相关性。嵌入在搜索、聚类、推荐、异常检测和分类任务中非常有用。
输入类型
输出类型
输入$0.02/百万 token
输出$0/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: Text Embedding 3 Large
openai/text-embedding-3-large
1.07Btoken
0%缓存命中率
text-embedding-3-large 是 OpenAI 最强大的嵌入模型,适用于英语和非英语任务。嵌入是文本的数值表示,可用于衡量两段文本之间的相关性。嵌入对于搜索、聚类、推荐、异常检测和分类任务非常有用。
输入类型
输出类型
输入$0.13/百万 token
输出$0/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-4.1 Mini
openai/gpt-4.1-mini
5.10Btoken
43.95%缓存命中率
GPT-4.1 Mini 是一款中型模型,其性能可与 GPT-4o 相媲美,但延迟更低,成本也大幅降低。它保留了 100 万 token 的上下文窗口,在 hard instruction evals 中得分 45.1%,在 MultiChallenge 中得分 35.8%,在 IFEval 中得分 84.1%。Mini 还表现出强大的编码能力(例如在 Aider’s polyglot diff benchmark 上得分为 31.6%)和视觉理解能力,使其适用于有严格性能限制的交互式应用程序。
输入类型
输出类型
输入$0.4/百万 token
输出$1.6/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-4o-mini
openai/gpt-4o-mini
18.18Btoken
49.51%缓存命中率
GPT-4o mini 是 OpenAI 在 GPT-4 Omni 之后推出的最新模型,支持文本和图像输入,并输出文本。作为其最先进的小型模型,它的价格比其他近期前沿模型低得多,且比 GPT-3.5 Turbo 便宜 60% 以上。它在保持 SOTA 智能水平的同时,性价比显著提升。GPT-4o mini 在 MMLU 测试中取得了 82% 的分数,目前在常见排行榜上的聊天偏好排名高于 GPT-4。
输入类型
输出类型
输入$0.15/百万 token
输出$0.6/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-4.1
openai/gpt-4.1
4.88Btoken
32.41%缓存命中率
GPT-4.1 是一款旗舰级大型语言模型,专为高级指令遵循、实际软件工程和长上下文推理而优化。它支持 100 万 token 的上下文窗口,在编程(54.6% SWE-bench Verified)、指令遵循(87.4% IFEval)和多模态理解基准测试中均优于 GPT-4o 和 GPT-4.5。它针对精确代码差异(code diffs)、代理可靠性和大型文档上下文中的高召回率微调了,使其成为代理、IDE 工具和企业知识检索的理想选择。
输入类型
输出类型
输入$2/百万 token
输出$8/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-4o
openai/gpt-4o
2.49Btoken
30.22%缓存命中率
GPT-4o("o"代表"omni")是OpenAI最新的AI模型,支持文本和图像输入以及文本输出。它在保持GPT-4 Turbo智能水平的同时,速度提升了两倍,成本降低了50%。GPT-4o还改进了对非英语语言的处理性能,并增强了视觉能力。为了与其他模型进行基准测试,它曾被简称为 "im-also-a-good-gpt2-chatbot"。
输入类型
输出类型
输入$2.5/百万 token
输出$10/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5 Pro
openai/gpt-5-pro
34.13Mtoken
0%缓存命中率
GPT-5 Pro 是 OpenAI 最先进的模型,在推理能力、代码质量和用户体验方面提供了重大改进。它针对需要逐步推理、指令遵循以及在高风险用例中保持准确性的复杂任务优化了。它支持测试时路由(test-time routing)功能和高级提示词理解,包括“think hard about this”等用户指定意图。改进包括减少幻觉、减少迎合性(sycophancy),并在编码、写作和健康相关任务中表现更好。
输入类型
输出类型
输入$15/百万 token
输出$120/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-6.1 Sol
openai/gpt-6.1-sol
71.70Btoken
94.12%缓存命中率
OpenAI: GPT-6.1 Sol 是一款专为智能体工作负载设计的生产级 OpenAI 模型,针对长周期和多步骤任务(如持续工具使用、复杂编码、计算机操作和专业工作流)优化了。它以显著更低的成本提供了接近 GPT-6 Astra 的能力,特别是极低的缓存输入定价,使其非常适合可复用上下文的智能体系统和企业部署场景。
输入类型
输出类型
输入$2-4/百万 token
输出$10-15/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5.4 Pro
openai/gpt-5.4-pro
417.16Mtoken
0%缓存命中率
GPT-5.4 Pro 是 OpenAI 最先进的模型,它基于 GPT-5.4 的统一架构,增强了处理复杂、高风险任务的推理能力。它拥有超过 1M token 的上下文窗口(922K 输入,128K 输出),并支持文本和图像输入。GPT-5.4 Pro 针对分步推理、指令遵循和准确性优化了,在智能体编码、长上下文工作流和多步问题解决方面表现卓越。
输入类型
输出类型
输入$30-60/百万 token
输出$180-270/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: Chat Latest (GPT-5.5 Instant)
openai/chat-latest
703.97Mtoken
79.32%缓存命中率
OpenAI: Chat Latest (GPT-5.5 Instant) 指向 ChatGPT 当前使用的最新 Instant 模型。我们建议大多数 API 用例使用我们的 latest-model,但你可以随时使用此模型来测试我们在聊天场景中的最新改进。底层的模型快照将定期更新。
输入类型
输出类型
输入$5/百万 token
输出$30/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5.5 Pro
openai/gpt-5.5-pro
1.05Btoken
0%缓存命中率
OpenAI: GPT-5.5 Pro 是 OpenAI 推出的高性能模型,专为处理复杂、高风险工作负载中的深度推理和高精度需求而优化。它拥有超过 100 万 token 的上下文窗口(922K 输入,128K 输出),支持文本和图像输入,用来实现长周期问题解决、智能体编码以及多步骤工作流程的精准执行。
输入类型
输出类型
输入$30-60/百万 token
输出$180-270/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5
openai/gpt-5
3.00Btoken
88.61%缓存命中率
GPT-5 是 OpenAI 最先进的模型,在推理、代码质量和用户体验方面提供了重大改进。它针对需要逐步推理、指令遵循和高风险用例准确性的复杂任务优化了。它支持测试时路由功能和高级提示理解,包括用户指定的意图,如 "think hard about this"(深度思考)。改进之处包括减少幻觉、谄媚,以及在编码、写作和健康相关任务中表现更好。
输入类型
输出类型
输入$1.25/百万 token
输出$10/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5 Nano
openai/gpt-5-nano
10.54Btoken
35.47%缓存命中率
GPT-5-Nano 是 GPT-5 系统中最小、最快的变体,专为开发工具、快速交互和超低延迟环境而优化。虽然与同系列的大型模型相比推理深度有限,但它保留了关键的指令遵循和安全功能。它是 GPT-4.1-nano 的继任者,为成本敏感或实时应用提供了轻量级选择。
输入类型
输出类型
输入$0.05/百万 token
输出$0.4/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5.6 Sol
openai/gpt-5.6-sol
232.17Btoken
97.01%缓存命中率
OpenAI: GPT-5.6 Sol 是 GPT-5.6 系列中的前沿模型。它大致相当于早期 GPT-5 系列中使用的无后缀模型层级。gpt-5.6 别名会将请求路由至 OpenAI: GPT-5.6 Sol。
输入类型
输出类型
输入$4-8/百万 token
输出$20-30/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5 Mini
openai/gpt-5-mini
4.98Btoken
42.33%缓存命中率
GPT-5 Mini 是 GPT-5 的精简版,专为处理轻量级推理任务而设计。它提供了与 GPT-5 相同的指令遵循和安全调整优势,但延迟更低、成本更低。GPT-5 Mini 是 OpenAI o4-mini 模型的后续产品。
输入类型
输出类型
输入$0.25/百万 token
输出$2/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5.1
openai/gpt-5.1
1.94Btoken
87.98%缓存命中率
GPT-5.1 是 GPT-5 系列中最新的前沿级模型,与 GPT-5 相比,它提供了更强的通用推理能力、更高的指令遵循度以及更自然的对话风格。它采用自适应推理技术来动态分配计算资源,在快速响应简单查询的同时,能对复杂任务进行深入处理。该模型能生成更清晰、更扎实的解释,并减少了术语使用,即使在处理技术性或多步骤问题时也更易于理解。GPT-5.1 专为广泛的任务覆盖而构建,在数学、编程和结构化分析工作负载中表现出持续的提升,并提供更连贯的长篇回答和更可靠的工具使用性能。另外,它还有改进的对话对齐功能,能实现更亲切、更直观的响应,且不牺牲精确度。GPT-5.1 是 GPT-5 的主要全功能继任者。
输入类型
输出类型
输入$1.25/百万 token
输出$10/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5.4 Nano
openai/gpt-5.4-nano
1.55Btoken
86.52%缓存命中率
输入类型
输出类型
输入$0.2/百万 token
输出$1.25/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5.2 Pro
openai/gpt-5.2-pro
528.38Mtoken
0%缓存命中率
GPT-5.2 Pro 是 OpenAI 最先进的模型,与 GPT-5 Pro 相比,它在 Agentic Coding 和长上下文性能方面有重大改进。它针对需要逐步推理、指令遵循和高风险用例准确性的复杂任务优化了。它支持 Test-time Routing 功能和高级 Prompt 理解,包括用户指定的意图,如“think hard about this”。改进之处包括减少幻觉和谄媚行为,以及在编码、写作和健康相关任务中表现更好。
输入类型
输出类型
输入$21/百万 token
输出$168/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-6 Astra
openai/gpt-6-astra
36.52Btoken
93.54%缓存命中率
OpenAI: GPT-6 Astra 是 OpenAI 目前处理复杂推理、编码、计算机使用、研究和文档创建能力最强的模型,在跨代码、浏览器和专业软件的多步骤工作流程中表现优异。它支持 low、medium、high、xhigh 和 max 等不同程度的 reasoning.effort,能在实现出色结果的同时,通过减少输出 token 的使用,这样降低单项任务的预估成本。另外,它也是 OpenAI 迄今为止对齐度最高的模型,用来精准遵循指令、遵守任务边界、适应不断变化的需求并实现透明沟通。
输入类型
输出类型
输入$10-20/百万 token
输出$50-75/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5.3-Codex
openai/gpt-5.3-codex
21.10Btoken
90.74%缓存命中率
GPT-5.3-Codex 是 OpenAI 最强大的智能体编程模型,用来处理不仅仅是代码生成,还包括计算机上的更长、端到端的任务。它结合了 GPT-5.2-Codex 的前沿编码能力以及 GPT-5.2 的推理和专业知识能力,并且在运行速度上优化了(Codex 速度提升约 25%)。它专为长周期、多步骤任务而设计,包括研究、工具使用、调试和复杂执行,同时保持交互性——所以你可以在其工作时引导它、提出问题并调整方向,而不会丢失上下文。在评估中,它在软件工程和智能体基准测试(包括 SWE-Bench Pro 和 Terminal-Bench 2.0)中创下了新高,并在 OSWorld-Verified 和 GDPval 上表现出色。另外,它部署了更强的网络安全保障措施,并经过专门训练以帮助识别软件漏洞。
输入类型
输出类型
输入$1.75/百万 token
输出$14/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5.4
openai/gpt-5.4
168.68Btoken
92.9%缓存命中率
GPT-5.4 发布于 2026 年 3 月 5 日,是 OpenAI 最新的前沿模型,用来处理复杂的专业工作。该模型可在 API 中以 gpt-5.4 的形式使用,在 ChatGPT 中则为 GPT-5.4 Thinking,并提供追求极致性能的更高级 GPT-5.4 Pro 版本。它支持通过 reasoning.effort 进行可调节的思考,使开发人员能以延迟/成本换取更深入的推理。该模型支持文本和图像输入并输出文本,拥有 1,050,000 token 的上下文窗口和高达 128,000 个输出 token;其公开的知识截止日期为 2025 年 8 月 31 日。OpenAI 还发布了一份系统卡片,描述了针对 Thinking 变体的新型网络安全缓解措施。
输入类型
输出类型
输入$2.5-5/百万 token
输出$15-22.5/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5.4 Mini
openai/gpt-5.4-mini
19.09Btoken
87.63%缓存命中率
输入类型
输出类型
输入$0.75/百万 token
输出$4.5/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5.2
openai/gpt-5.2
76.90Btoken
91.13%缓存命中率
GPT-5.2 是 GPT-5 系列中最新的前沿级模型,在智能体能力和长上下文处理方面优于 GPT-5.1。它使用自适应推理来动态分配计算资源,既能快速响应简单问题,也能对复杂任务进行深度分析。GPT-5.2 专为广泛的任务覆盖而设计,在数学、编码、科学和工具调用工作负载方面实现了持续改进,可生成更连贯的长文本回复,并提供更可靠的工具使用体验。
输入类型
输出类型
输入$1.75/百万 token
输出$14/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5.5
openai/gpt-5.5
208.34Btoken
92.87%缓存命中率
OpenAI: GPT-5.5 能更快地理解你的意图,并能独立承担更多工作。它擅长编写和调试代码、在线研究、分析数据、创建文档和电子表格、操作软件,并能在不同工具间切换直至完成任务。无需事无巨细地管理每一步,你可以将杂乱的多部分任务交给 OpenAI: GPT-5.5,放心让它进行规划、使用工具、核查工作、应对模糊性并持续推进直至完成。
输入类型
输出类型
输入$5-10/百万 token
输出$30-45/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-6 Sol
openai/gpt-6-sol
28.42Btoken
96.82%缓存命中率
OpenAI: GPT-6 Sol 是 OpenAI GPT-6 系列中的高性价比高端模型,定位在旗舰级 GPT-6 Astra 之下、快速级 GPT-6 Luna 之上。它适用于要求严苛的专业工作、代理编码、业务工作流自动化及计算机使用,尤其擅长真实代码库中的长跨度软件工程任务。它以极低的成本实现了接近 Astra 级的可靠性,并在技术与编程对话中延续了 Astra 清晰、简洁的沟通风格。
输入类型
输出类型
输入$2-4/百万 token
输出$10-15/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5.6 Terra
openai/gpt-5.6-terra
70.54Btoken
93.83%缓存命中率
OpenAI: GPT-5.6 Terra 是一款高性能的 GPT-5.6 系列模型,专为长文本、支持工具的工作流而设计,涵盖写作、编码、分析和多步骤问题解决等任务。它支持文本、图像和文件输入以及文本输出,并针对强大的指令遵循、可靠的推理和复杂任务的精准执行优化了。
输入类型
输出类型
输入$2-4/百万 token
输出$12-18/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-5.6 Luna
openai/gpt-5.6-luna
229.23Btoken
92.63%缓存命中率
OpenAI: GPT-5.6 Luna 是 OpenAI GPT-5.6 系列中一款快速且经济高效的模型。它适用于聊天、分类和轻量级代理工作流等高并发、低延迟要求的任务,在其价格区间内提供出色的推理能力。
输入类型
输出类型
输入$0.2-0.4/百万 token
输出$1.2-1.8/百万 token
上下文-
最大输出-
可用于 1 个供应商
OpenAI: GPT-6 Luna
openai/gpt-6-luna
92.81Btoken
94.18%缓存命中率
OpenAI: GPT-6 Luna 是 OpenAI GPT-6 系列中快速且具成本效益的模型,定位低于 GPT-6 Sol。它适用于高并发和对延迟敏感的工作负载,例如聊天、分类和轻量级代理任务;在更高的推理工作量下,它能承担此前需要 Sol 级模型才能完成的复杂软件工程和计算机使用任务。它共享了 GPT-6 系列在事实可靠性方面的提升,以及更清晰、更简洁的沟通风格。
输入类型
输出类型
输入$0.1-0.2/百万 token
输出$0.5-0.75/百万 token
上下文-
最大输出-
可用于 1 个供应商