
对于需要低延迟的任务,GPT-4.1 Nano 是 GPT-4.1 系列中最快、最经济的模型。它以小巧的体量提供卓越的性能,拥有 100 万 token 的上下文窗口,在 MMLU 上得分为 80.1%,在 GPQA 上得分为 50.3%,在 Aider polyglot coding 上得分为 9.8%——甚至高于 GPT-4o mini。它非常适合分类或自动补全等任务。
返回模型列表 62.1%$0.1/ 百万 token$0.4/ 百万 token读取:0.03/ 百万 token写入:-/ 百万 token1.05M0.94s7.63tps
 -$0.1/ 百万 token$0.4/ 百万 token读取:0.025/ 百万 token写入:-/ 百万 token1.05M--
供应商
在多个供应商之间路由请求。复制供应商标识以设置偏好供应商。
供应商缓存命中率上下文
Azure
azure
OpenAI下线
openai
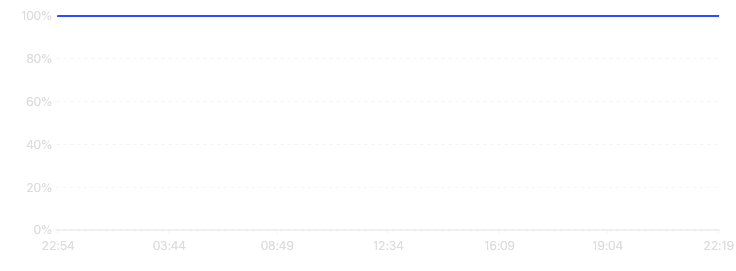
可用率
24 小时AI Gateway 直连请求及各供应商的成功率。
Oct 26, 19:54
Azure100.00%
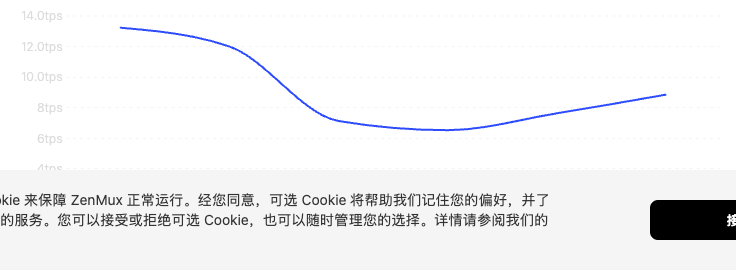
吞吐量
24 小时AI Gateway 实时流量的 P50 吞吐量,单位为每秒 token 数(TPS)。
Oct 26, 18:00
Azure7.63 tps
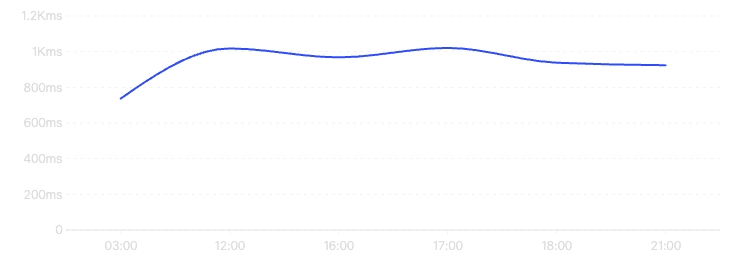
延迟
24 小时AI Gateway 实时流量的 P50 首 token 延迟(TTFT),单位为毫秒。
Oct 26, 18:00
Azure0.94s
活动
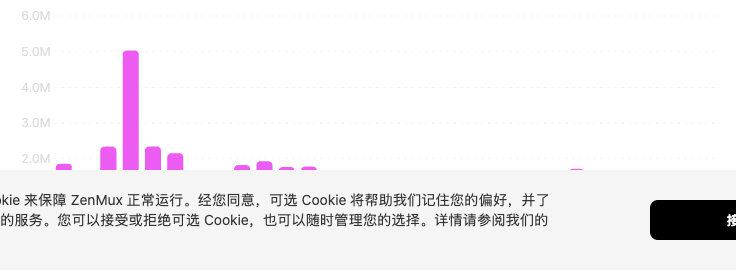
该模型随时间变化的 token 用量和请求流量。
Token 消耗
Oct 25
OpenAI-
Azure848.9K
按实际处理请求的供应商拆分 token 用量。区块越大,表示该供应商处理的模型流量越多。
 Artificial Analysis


Apps
Public apps that send the most traffic to this model. Good signal for what real production workloads look like — and a hint at which use cases this model is best suited for. View All
Token 排行


相关模型
更多模型来自 OpenAI